让 AI 直接调用 Qwen3-TTS 语音接口
语音克隆 API:文本进、音频 URL 出。上传 3–60 秒参考音频即可克隆音色(推荐 3–10 秒清晰干声), 支持普通话、英语、14 种中文方言、7 种民族语言与 100+ 语种;提供 REST 接口与机读 OpenAPI 3.0 规范, 扣子、Dify、n8n、WorkBuddy、OpenClaw、ComfyUI、Claude Code、Codex 均可直接接入。
这是什么:Qwen3-TTS 语音开放接口,10 个 REST 端点覆盖声音克隆、语音合成、8 维情绪向量控制与音频降噪。
适合什么:短剧多角色批量配音、方言口播、有声书长文本——需要把「文本变成某个人的声音」自动化的场景。
谁能用:旗舰会员。密钥即请求头 sign;API 不另收费,与套餐共享字符额度。
怎么接:扣子 / Dify / n8n 导入 openapi.json;WorkBuddy / Claude Code / Codex 导入官方技能包;ComfyUI 装官方节点。
我该走哪条路新增
按你的情况选一条,每条都能在 10 分钟内跑通。
账号与密钥
API 能力面向旗舰会员开放,密钥即请求头中的 sign。全部功能均支持 API 接口调用, API 不额外收费,与套餐共享字符额度。下面的文档可先通读,无需登录。
全部功能均支持 API 接口调用
未开通:点右侧按钮开通旗舰会员,开通即生效。已开通:点右侧按钮直接显示密钥,可复制。
快速开始
三步跑通:取音色 ID → 创建合成任务 → 轮询结果。
- 拿到音色 ID:调
GET /api/third/reference/list,取list[].audioId;也可先用/reference/upload上传 3–60 秒干声创建自己的音色。 - 创建合成任务:调
POST /api/third/tts/create,audioId填上一步的值,返回taskId。 - 轮询结果:调
GET /api/third/tts/result?taskId=,status=2时取voiceUrl(建议 2 秒一次,不要重复创建任务)。
# 1) 取音色列表,拿到 audioId
curl "https://openapi.aivoiceapi.cn/api/third/reference/list?page=1&pageSize=10" \
  -H "sign: $VOICE_API_KEY"

# 2) 创建合成任务,返回 taskId
curl -X POST https://openapi.aivoiceapi.cn/api/third/tts/create \
  -H "sign: $VOICE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
        "content": "今天天气不错",
        "audioId": "<audioId>",
        "style": "2",
        "speed": 1.0,
        "targetSpeech": "mandarin"
      }'

# 3) 轮询结果,status=2 时取 voiceUrl
curl "https://openapi.aivoiceapi.cn/api/third/tts/result?taskId=<taskId>" \
  -H "sign: $VOICE_API_KEY"
预期结果:第 2 步返回 data.taskId,第 3 步轮询到 status=2 时返回 data.voiceUrl。
import os, time, requests

BASE = "https://openapi.aivoiceapi.cn"
H = {"sign": os.environ["VOICE_API_KEY"]}

# 1) 取音色
r = requests.get(f"{BASE}/api/third/reference/list",
                 headers=H, params={"page": 1, "pageSize": 10}).json()
assert r["code"] == 0, r["msg"]          # 永远先判 code
audio_id = r["data"]["list"][0]["audioId"]

# 2) 创建合成任务
r = requests.post(f"{BASE}/api/third/tts/create", headers=H, json={
    "content": "今天天气不错",
    "audioId": audio_id,
    "style": "2",
    "speed": 1.0,
    "targetSpeech": "mandarin",
}).json()
assert r["code"] == 0, r["msg"]
task_id = r["data"]["taskId"]

# 3) 轮询结果(2 秒一次,不要重复创建任务)
while True:
    time.sleep(2)
    r = requests.get(f"{BASE}/api/third/tts/result",
                     headers=H, params={"taskId": task_id}).json()
    assert r["code"] == 0, r["msg"]
    data = r["data"]
    if data["status"] == 2:
        print(data["voiceUrl"]); break
    if data["status"] == 3:
        raise RuntimeError("合成失败")
const BASE = "https://openapi.aivoiceapi.cn";
const KEY = process.env.VOICE_API_KEY;
const H = { sign: KEY, "Content-Type": "application/json" };
const sleep = ms => new Promise(r => setTimeout(r, ms));
// 1) 取音色
const listRes = await fetch(
`${BASE}/api/third/reference/list?page=1&pageSize=10`,
{ headers: { sign: KEY } }
).then(r => r.json());
if (listRes.code !== 0) throw new Error(listRes.msg); // 永远先判 code
const audioId = listRes.data.list[0].audioId;
// 2) 创建合成任务
const createRes = await fetch(`${BASE}/api/third/tts/create`, {
method: "POST",
headers: H,
body: JSON.stringify({
content: "今天天气不错",
audioId,
style: "2",
speed: 1.0,
targetSpeech: "mandarin",
}),
}).then(r => r.json());
if (createRes.code !== 0) throw new Error(createRes.msg);
const taskId = createRes.data.taskId;
// 3) 轮询结果(2 秒一次,不要重复创建任务)
while (true) {
await sleep(2000);
const res = await fetch(
`${BASE}/api/third/tts/result?taskId=${taskId}`,
{ headers: { sign: KEY } }
).then(r => r.json());
if (res.code !== 0) throw new Error(res.msg);
if (res.data.status === 2) { console.log(res.data.voiceUrl); break; }
if (res.data.status === 3) throw new Error("合成失败");
}鉴权与响应约定
Base URL
https://openapi.aivoiceapi.cn鉴权
每个请求带请求头 sign: <你的密钥>。也支持 query ?sign=,但优先用请求头。
sign: YOUR_API_KEY密钥无效或旗舰会员过期时返回「sign无效」/「会员已过期」。
统一响应格式
{
  "code": 0,
  "msg": "操作成功",
  "data": { }
}code=0成功;7通用失败;1001字数超限。- 永远先判
code,失败时 HTTP 状态码仍可能是 200。 - 失败时
msg是中文原因,可直接透传给用户。
接口清单
12 个端点分四组:声音模型 3 个、语音合成 4 个、语音降噪 2 个、声音设计 3 个。 所有路径前缀 /api/third,均需 sign 头(openapi.json 除外)。 机读规范:https://openapi.aivoiceapi.cn/api/third/openapi.json,可直接导入扣子 / Dify / n8n。
声音模型相关3 个接口
POST/api/third/reference/upload模型创建
上传一段音频作为音色参考,返回的 audioId 直接用于合成。
| 表单(multipart/form-data) | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| file | binary | 是 | — | mp3 / wav / m4a,≤50MB,时长 2–60 秒(推荐 3–10 秒清晰干声) |
| name | string | 是 | — | 模型名称 |
| describe | string | 否 | — | 模型描述 |
curl -X POST https://openapi.aivoiceapi.cn/api/third/reference/upload \
  -H "sign: $VOICE_API_KEY" \
  -F "file=@/path/voice.wav" \
  -F "name=小明" \
  -F "describe=低沉男声"
{
"code": 0, "msg": "操作成功",
"data": { "audioId": "role_xxx", "name": "小明", "describe": "低沉男声" }
}GET/api/third/reference/list模型列表获取
返回账号下全部可用音色(接口上传的 + 网页端创建的),作为 TTS 的 audioId 候选。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| page | int | 否 | 1 | 页码 |
| pageSize | int | 否 | 10 | 每页条数,最大 30 |
GET /api/third/reference/list?page=1&pageSize=10
sign: YOUR_API_KEY
{
"code": 0, "msg": "操作成功",
"data": {
"list": [
{ "audioId": "role_xxx", "name": "小明", "describe": "低沉男声" }
],
"total": 8, "page": 1, "pageSize": 10
}
}DELETE/api/third/reference/delete删除模型数据
删除指定音色,删除后不可用于合成。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| audioId | string | 是 | — | 模型 ID |
curl -X DELETE "https://openapi.aivoiceapi.cn/api/third/reference/delete?audioId=role_xxx" \
  -H "sign: $VOICE_API_KEY"
{ "code": 0, "msg": "操作成功", "data": {} }语音合成相关4 个接口
POST/api/third/file/uploadCustom参考音频上传
上传一段带目标情绪的音频,返回的文件名填入 TTS 的 emotionPath(配合 genre=2)。属临时文件,会被定时清理,过期需重传。
| 表单(multipart/form-data) | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| file | binary | 是 | — | mp3 / wav / m4a,≤50MB,时长 2–60 秒 |
curl -X POST https://openapi.aivoiceapi.cn/api/third/file/uploadCustom \
  -H "sign: $VOICE_API_KEY" \
  -F "file=@/path/emotion.wav"
{
"code": 0, "msg": "操作成功",
"data": { "emotionPath": "20260817_xxxxxx.wav" }
}POST/api/third/tts/create异步语音合成
提交后立刻返回 taskId,再用 /tts/result 轮询。接口提交支持最大 30 个任务排队;生成的语音文件与记录保留 1 天,请尽快下载。content 里可插入停顿标记:#0.3# #0.5# #1.0# #1.5# #2.0# #3.0#。
| 请求体(JSON) | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| content | string | 是 | — | 要合成的文本,上限 10000 字符,超出返回 code=1001 |
| audioId | string | 是 | — | 音色 ID,来自 /reference/list 或 /reference/upload |
| style | string | 是 | — | 必须是字符串。"1"=V2.0,"2"=V2.5(唯一支持情绪),"3"=方言/多语言。传了该 style 不支持的 targetSpeech 时,服务端强制改写为 "3" |
| speed | number | 否 | 1.0 | 语速 0.5–2.0,一位小数。方言/多语言链路模型上限 1.5,服务端下发前自动压缩 |
| targetSpeech | enum | 否 | 自动判定 | 目标语言/方言,57 个取值,强烈建议显式传。枚举外语言:改用 style="3" 且不传本字段 |
| genre | int | 否 | 0 | 情绪控制方式,仅 style="2" 生效。0=跟随参考音频,1=情绪向量(配 ext),2=情绪参考音频(配 emotionPath) |
| ext | object | genre=1 | — | 情绪向量,8 个维度 happy / angry / sad / afraid / disgusted / melancholic / surprised / calm,各取 [0,1],可多维同时赋值。传未知字段直接报错 |
| emotionPath | string | genre=2 | — | 情绪参考音频文件名,来自 /file/uploadCustom |
{
  "content": "今天天气不错,适合出门走走。",
  "audioId": "role_xxx",
  "style":   "2",
  "speed":   1.0,
  "targetSpeech": "mandarin"
}
{
"code": 0,
"msg": "操作成功",
"data": { "taskId": "task_xxx", "status": 1 }
}GET/api/third/tts/list语音合成列表查询
按分页返回历史合成任务。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| page | int | 否 | 1 | 页码 |
| pageSize | int | 否 | 10 | 每页条数,最大 30 |
GET /api/third/tts/list?page=1&pageSize=10
sign: YOUR_API_KEY
{
"code": 0, "msg": "操作成功",
"data": {
"list": [
{ "taskId": "task_xxx", "status": 2, "voiceUrl": "https://.../xxx.mp3" }
],
"total": 42, "page": 1, "pageSize": 10
}
}GET/api/third/tts/result查询 taskId 结果
用 /tts/create 返回的 taskId 轮询,建议 2 秒一次。语音下载地址同样需要带 sign(请求头或拼在 URL 的 query 上)。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| taskId | string | 是 | — | 任务 ID |
GET /api/third/tts/result?taskId=task_xxx
sign: YOUR_API_KEY
{
"code": 0,
"msg": "操作成功",
"data": {
"taskId": "task_xxx",
"status": 2, // 1=处理中 2=已完成 3=失败
"voiceUrl": "https://.../xxx.mp3" // status=2 时才有
}
}语音降噪2 个接口
POST/api/third/denoise/upload语音降噪
上传音频做降噪,返回 taskId。单用户进行中的降噪任务上限 5 个;降噪不单独计费。
| 表单(multipart/form-data) | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| file | binary | 是 | — | 音频文件,时长 3–60 秒 |
curl -X POST https://openapi.aivoiceapi.cn/api/third/denoise/upload \
  -H "sign: $VOICE_API_KEY" \
  -F "file=@/path/noisy.wav"
{
"code": 0, "msg": "操作成功",
"data": { "taskId": "dn_xxx" }
}GET/api/third/denoise/poll语音降噪结果
注意这里的 status 是字符串,与 TTS 的数字状态不同。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| taskId | string | 是 | — | 降噪任务 ID |
GET /api/third/denoise/poll?taskId=dn_xxx
sign: YOUR_API_KEY
{
"code": 0, "msg": "操作成功",
"data": {
"status": "completed", // processing | completed | failed
"filePath": "https://.../clean.wav",
"message": "" // status=failed 时是失败原因
}
}声音设计3 个接口
POST/api/third/dubbing/create声音设计(异步)
用文字描述或方言参数直接设计音色并合成,无需参考音频。返回 dubbId,用 /dubbing/result 轮询。单用户进行中任务上限 5 个,结果保留 1 天。
| 请求体(JSON) | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| content | string | 是 | — | 要合成的文本,上限 1000 字节(一个汉字 3 字节) |
| engine | int | 否 | 1 | 设计方式:1=描述设计,2=方言设计 |
| description | string | engine=1 | — | 音色的自由文本描述,如「沉稳低沉的男声,语速偏慢」。engine=2 时选填,一旦填了就整体原样下发,其余参数被忽略 |
| language | enum | 否 | — | 语言 / 方言,见下方取值表。仅 engine=2 生效 |
| gender | enum | 否 | — | male / female。仅 engine=2 生效 |
| age | enum | 否 | — | child / teen / youth / middle_aged / elderly。仅 engine=2 生效 |
| pitch | enum | 否 | — | very_low / low / medium / high / very_high。仅 engine=2 生效 |
| voiceStyle | enum | 否 | 自然 | 留空=自然,whisper=耳语。仅 engine=2 生效 |
| accent | enum | 否 | — | 英文口音,仅 language="english" 时可用,选中文方言时不能传。见下方取值表 |
{
  "content": "今天天气不错,出去走走吧",
  "engine":  1,
  "description": "沉稳低沉的男声,语速偏慢"
}
{
"content": "今天天气不错,出去走走吧",
"engine": 2,
"language": "sichuan",
"gender": "female",
"age": "youth",
"pitch": "medium",
"voiceStyle": "",
"accent": ""
}{
"code": 0, "msg": "操作成功",
"data": { "dubbId": "dubb_xxx" }
}GET/api/third/dubbing/result查询声音设计结果
用 dubbId 轮询,完成后取 voiceUrl。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| dubbId | string | 是 | — | 声音设计任务 ID |
GET /api/third/dubbing/result?dubbId=dubb_xxx
sign: YOUR_API_KEY
{
"code": 0, "msg": "操作成功",
"data": {
"dubbId": "dubb_xxx",
"status": 2, // 1=处理中 2=已完成 3=失败
"voiceUrl": "https://.../xxx.mp3" // status=2 时才有
}
}GET/api/third/dubbing/list声音设计任务列表
按分页返回声音设计任务;接口不回传设计参数与文案,需要展示请自行留存。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| page | int | 否 | 1 | 页码 |
| pageSize | int | 否 | 10 | 每页条数,最大 30 |
GET /api/third/dubbing/list?page=1&pageSize=10
sign: YOUR_API_KEY
{
"code": 0, "msg": "操作成功",
"data": {
"list": [
{ "dubbId": "dubb_xxx", "status": 2, "voiceUrl": "https://.../xxx.mp3" }
],
"total": 3, "page": 1, "pageSize": 10
}
}参数规则
按「语音合成」「声音设计」两块分开列;接口卡片里的「参数详解」会直接跳到对应小节。
语音合成参数(/tts/create)
style 是字符串
"style": "2" ✅ "style": 2 ❌(返回类型错误)。
"1"V2.0 基础合成,genre只能传 0。"2"V2.5,唯一支持情绪控制的版本。"3"方言 / 多语言,不支持情绪控制——传了genre/ext不报错但也不生效。
传了 targetSpeech 而该语言不支持所选 style 时,服务端会强制改写为 "3",响应里返回改写后的值。
情绪控制三选一(仅 style="2")
genre: 0— 跟随参考音频情绪(默认,无需额外参数)genre: 1— 情绪向量,用ext指定 8 个维度:happy / angry / sad / afraid / disgusted / melancholic / surprised / calm,各取值[0,1],可同时给多个。传未知字段会直接报错。genre: 2— 情绪参考音频,先/file/uploadCustom拿文件名,填入emotionPath
Web 端情绪控制属专业会员能力;用旗舰会员 API Key 调本接口默认可用,无需额外开通。
targetSpeech(目标语言 / 方言)
非必填但强烈建议显式提交。不传时服务端按文本自动判定,短文本或中英混排容易判错。
mandarin/english:style 1/2/3 都支持,可用情绪控制ja/es/ar:style="2" 可用情绪控制;style="1" 会被升为 "3"- 其余(14 种中文方言 + 7 种民族语言 + 40 种独立语言):style 传 "3",不支持情绪控制
- 枚举外的语言会直接报错「暂不支持该语言」且任务不会创建。此时改为
style="3"且完全不传targetSpeech,由多语言模型按文本自行处理
枚举收录 57 个(下方全量列出),服务端能力表实际支持 100+ 语种,枚举里没有不代表不支持,可直接试传。
speed 与轮询
speed入参校验上限2.0;方言 / 多语言链路模型上限只有1.5,服务端下发前自动压缩,不影响入参。- 用
/tts/create时建议 2 秒一次轮询/tts/result,直到status变为 2 或 3。 - 轮询期间
status=1就继续等,不要重复创建任务;接口提交最多 30 个任务排队。
targetSpeech 全量取值(57 个)
支持情绪控制5
style="2"(V2.5)可用 genre/ext;mandarin 与 english 三个 style 都支持
mandarin普通话english英语ja日语es西班牙语ar阿拉伯语
中文方言14
强制走 style="3",不支持情绪控制;文案用普通话写即可,模型负责转腔调
sichuan四川话northeast东北话henan河南话shaanxi陕西话guizhou贵州话yunnan云南话guilin桂林话jinan济南话shijiazhuang石家庄话gansu甘肃话ningxia宁夏话qingdao青岛话yue粤语nan闽南语
少数民族语言5
强制走 style="3",不支持情绪控制
ug维吾尔语bo藏语mn蒙古语kk哈萨克语ky柯尔克孜语
其他语言33
强制走 style="3",不支持情绪控制
ko韩语fr法语de德语ru俄语pt葡萄牙语it意大利语th泰语vi越南语id印尼语ms马来语hi印地语fa波斯语tr土耳其语ur乌尔都语bn孟加拉语ta泰米尔语nl荷兰语pl波兰语sv瑞典语no挪威语da丹麦语fi芬兰语el希腊语cs捷克语hu匈牙利语uk乌克兰语he希伯来语fil菲律宾语my缅甸语km高棉语lo老挝语ne尼泊尔语sw斯瓦希里语
声音设计参数(/dubbing/create)
engine=1 · 描述设计
只需 content + description,用自然语言描述音色,如「沉稳低沉的男声,语速偏慢」。
engine=2 时若也传了 description,则按描述整体下发,下表里的参数全部被忽略。
engine=2 · 方言设计
用下表的英文枚举组合出音色,支持 12 种中文方言与 10 种英文口音。
文案书写:中文方言写普通话文案即可,模型负责转腔调;粤语 / 维吾尔语 / 英文需用该语言书写;闽南语只支持台罗拼音(Tâi-lô),不支持汉字。
| 参数 | 可选值 |
|---|---|
| language(中文方言) | sichuan 四川 / northeast 东北 / henan 河南 / shaanxi 陕西 / guizhou 贵州 / yunnan 云南 / guilin 桂林 / jinan 济南 / shijiazhuang 石家庄 / gansu 甘肃 / ningxia 宁夏 / qingdao 青岛 |
| language(其他) | chinese 普通话 / cantonese 粤语 / minnan 闽南语 / uyghur 维吾尔语 / english 英文;表外语言直接传英文语言名(如 Thai) |
| accent(英文口音) | american / british / australian / canadian / indian / chinese / korean / japanese / portuguese / russian;仅 language="english" 时使用,选中文方言时不能传 |
| gender | male 男声 / female 女声 |
| age | child 儿童 / teen 少年 / youth 青年 / middle_aged 中年 / elderly 老年 |
| pitch | very_low 极低 / low 低 / medium 中 / high 高 / very_high 极高 |
| voiceStyle | 留空 = 自然(默认)/ whisper 耳语 |
API 参数与 Qwen3-TTS 网页版功能的对应关系新增
| API 参数 | 网页端对应 | 说明 |
|---|---|---|
style="1" | V2.0 极速引擎 | 中英,长文本稳定 |
style="2" | V2.5 高保真引擎 | 唯一支持情绪;中英日西阿 |
style="3" | 方言与多语言 | 不支持情绪 |
genre 0 / 1 / 2 | 情绪语气三重控制 | 仅 style="2" |
speed | 语速滑杆 0.5–2.0x | 方言链路上限 1.5 |
targetSpeech | 「选择配音语言」弹窗 | 网页端开放 14 方言 + 7 民族语言 + 35 全球语言;API 枚举 57,能力 100+ |
/reference/upload | 创建声音模型 | API 允许 3–60 秒,推荐 3–10 秒清晰干声 |
/denoise/* | AI 降噪 | 网页端免费不计额度;API 同样不单独计费 |
/dubbing/create engine=1 | 声音设计 · 描述设计 | 用 description 自然语言描述音色,无需参考音频 |
/dubbing/create engine=2 | 声音设计 · 方言设计 | 12 种中文方言 + 10 种英文口音,参数组合生成 |
智能体接入
六个平台底层都是同一套 /api/third/* 接口与同一份额度,按你在用的平台选一个 tab, 每个 tab 里都是可整段粘贴的内容。
扣子 2.0 起同时支持 Skill 与插件两条路:Skill 可直接上传 SKILL.md 技能包 zip,插件走 OpenAPI 导入。要在工作流节点里用就选插件。
把技能包目录打包成 .zip,在扣子的 Skill / 技能管理里上传导入——Anthropic 那套 SKILL.md + 脚本的目录结构是兼容的。导入后点「部署」,在对话里 @ 这个技能即可使用。
# 下载并打包
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts
cd autoclaw-skill-tts && zip -r ../qwen3-tts-skill.zip .

# 或直接下载现成 zip:
https://github.com/OpenApiTTS/autoclaw-skill-tts/archive/refs/heads/main.zip要在工作流节点里调用就走这条。扣子 → 插件 → 创建插件 → 选择「导入」→ 粘贴 OpenAPI 地址:
https://openapi.aivoiceapi.cn/api/third/openapi.json授权方式选 Service(服务认证)→ Location 选 Header → Parameter name 填 sign → Service token 填你的 API Key。
Location:        Header
Parameter name:  sign
Service token: YOUR_API_KEY逐个调试工具通过后点「发布」,然后在你的智能体(Bot)里添加该插件。典型编排:reference/list 取音色 → tts/create 提交 → 轮询 tts/result 取 data.voiceUrl。
常见坑:插件未发布就无法在智能体里选中;参数 style 必须以字符串传(扣子表单里填 "2" 而不是 2);扣子上的 Skill 目前只能单个使用、多个 Skill 之间不能互相调用,需要串多步时用插件 + 工作流兜底。
WorkBuddy 原生支持 SKILL.md 技能机制,直接导入官方技能包即可;也可以走 OpenAPI 自定义工具在工作流里编排。
下载技能包后,在 WorkBuddy 里选择导入自定义 Skill(或把目录放进它的技能目录)。技能包就是一个标准的 SKILL.md + scripts/ 结构,WorkBuddy 可直接识别。
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts
# 或下载 zip:https://github.com/OpenApiTTS/autoclaw-skill-tts/archive/refs/heads/main.zip把 API Key 写进环境变量并重启客户端,之后在对话里直接描述需求即可,WorkBuddy 会按 SKILL.md 的 SOP 自动完成取音色 → 合成 → 落盘。
export VOICE_API_KEY="YOUR_API_KEY"

# 然后直接说:
把这段文案用四川话合成语音,存到桌面:巴适得很,安逸得板。需要在工作流里精细编排时用这条路。新建自定义工具 → 从 OpenAPI 导入,鉴权选自定义请求头,Header 名 sign,值填 API Key。典型编排:reference/list 取音色 → tts/create 提交 → 轮询 tts/result 取 data.voiceUrl。
https://openapi.aivoiceapi.cn/api/third/openapi.json两种都不方便时,配一个 POST 请求节点即可:
POST https://openapi.aivoiceapi.cn/api/third/tts/create
Header: sign: YOUR_API_KEY
Header: Content-Type: application/json
Body:
{
  "content": "{{输入文本}}",
  "audioId": "{{音色ID}}",
  "style": "2",
  "targetSpeech": "mandarin"
}
取值:data.voiceUrl常见坑:环境变量用 setx / export 设置后必须重启 WorkBuddy 客户端,它在启动时就已读取;自定义工具未保存或未发布时在工作流里选不中;响应判断要看 body 里的 code 字段而不是 HTTP 状态码。
两者都走 OpenAPI 自定义工具:导入规范 → 配置自定义 Header 鉴权 → 在工作流里串两个节点。
Dify:工具 → 自定义 → 导入 OpenAPI Schema;n8n:HTTP Request 节点或 Custom API 均可,推荐直接导入规范地址。
https://openapi.aivoiceapi.cn/api/third/openapi.json鉴权类型选自定义 Header(不是 Bearer),名称 sign,值填 API Key。
Auth Type:  Custom Header
Header:     sign
Value: YOUR_API_KEY先 reference/list 取音色,再 tts/create 提交任务,循环轮询 tts/result,输出取 data.voiceUrl。
常见坑:响应判断要看 body 里的 code 字段而不是 HTTP 状态码;style 必须传字符串 "2";n8n 的 HTTP 节点记得把 Content-Type 设为 application/json。
OpenClaw 支持技能(Skill)目录,把官方技能包放进去即可用自然语言驱动。
把整个目录复制到 OpenClaw 的技能目录下(保持 SKILL.md 与 scripts/tts.py 的相对位置不变)。
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts

skills/
└── skill-openapi/
    ├── SKILL.md
    ├── scripts/tts.py
└── target-speech-enum.csv在 OpenClaw 的运行环境里配置环境变量,然后重启客户端——它在启动时就已读取环境变量。
export VOICE_API_KEY="YOUR_API_KEY"把这段文案用四川话合成语音,存到桌面:巴适得很,安逸得板。常见坑:技能目录规范以 OpenClaw 当前文档为准;若它只输出命令而不执行,说明缺少本地命令执行权限,需在设置里放开。
推荐直接装官方节点包:git clone 到 custom_nodes 重启,画布里就出现「上传音色 / 选择已有音色 / 合成语音 / 一键合成」四个节点,长文本自动分段拼接,不用自己搭轮询循环。若不想装节点包,下面保留了 HTTP 节点、脚本节点两种接法;想让 Agent(Claude Code 等)同时驱动 ComfyUI 和我们的接口,见最后一条。工作流本身没有 SKILL.md 机制。
三种装法任选其一,无需 pip install,只依赖 Python 标准库与 ComfyUI 自带的 torch。装好后重启 ComfyUI,在 audio/VoiceClone 分类下即可搜到四个节点。密钥推荐走环境变量——导出 workflow.json 会把输入框里的密钥一起带出去。仓库:comfyui-voiceclone-tts
# ① git clone
cd ComfyUI/custom_nodes
git clone https://github.com/OpenApiTTS/comfyui-voiceclone-tts

# ② ComfyUI-Manager → Install via Git URL
https://github.com/OpenApiTTS/comfyui-voiceclone-tts

# ③ 下载 zip 解压到 ComfyUI/custom_nodes/comfyui-voiceclone-tts/

# 配置密钥后重启 ComfyUI
export VOICE_API_KEY="YOUR_API_KEY"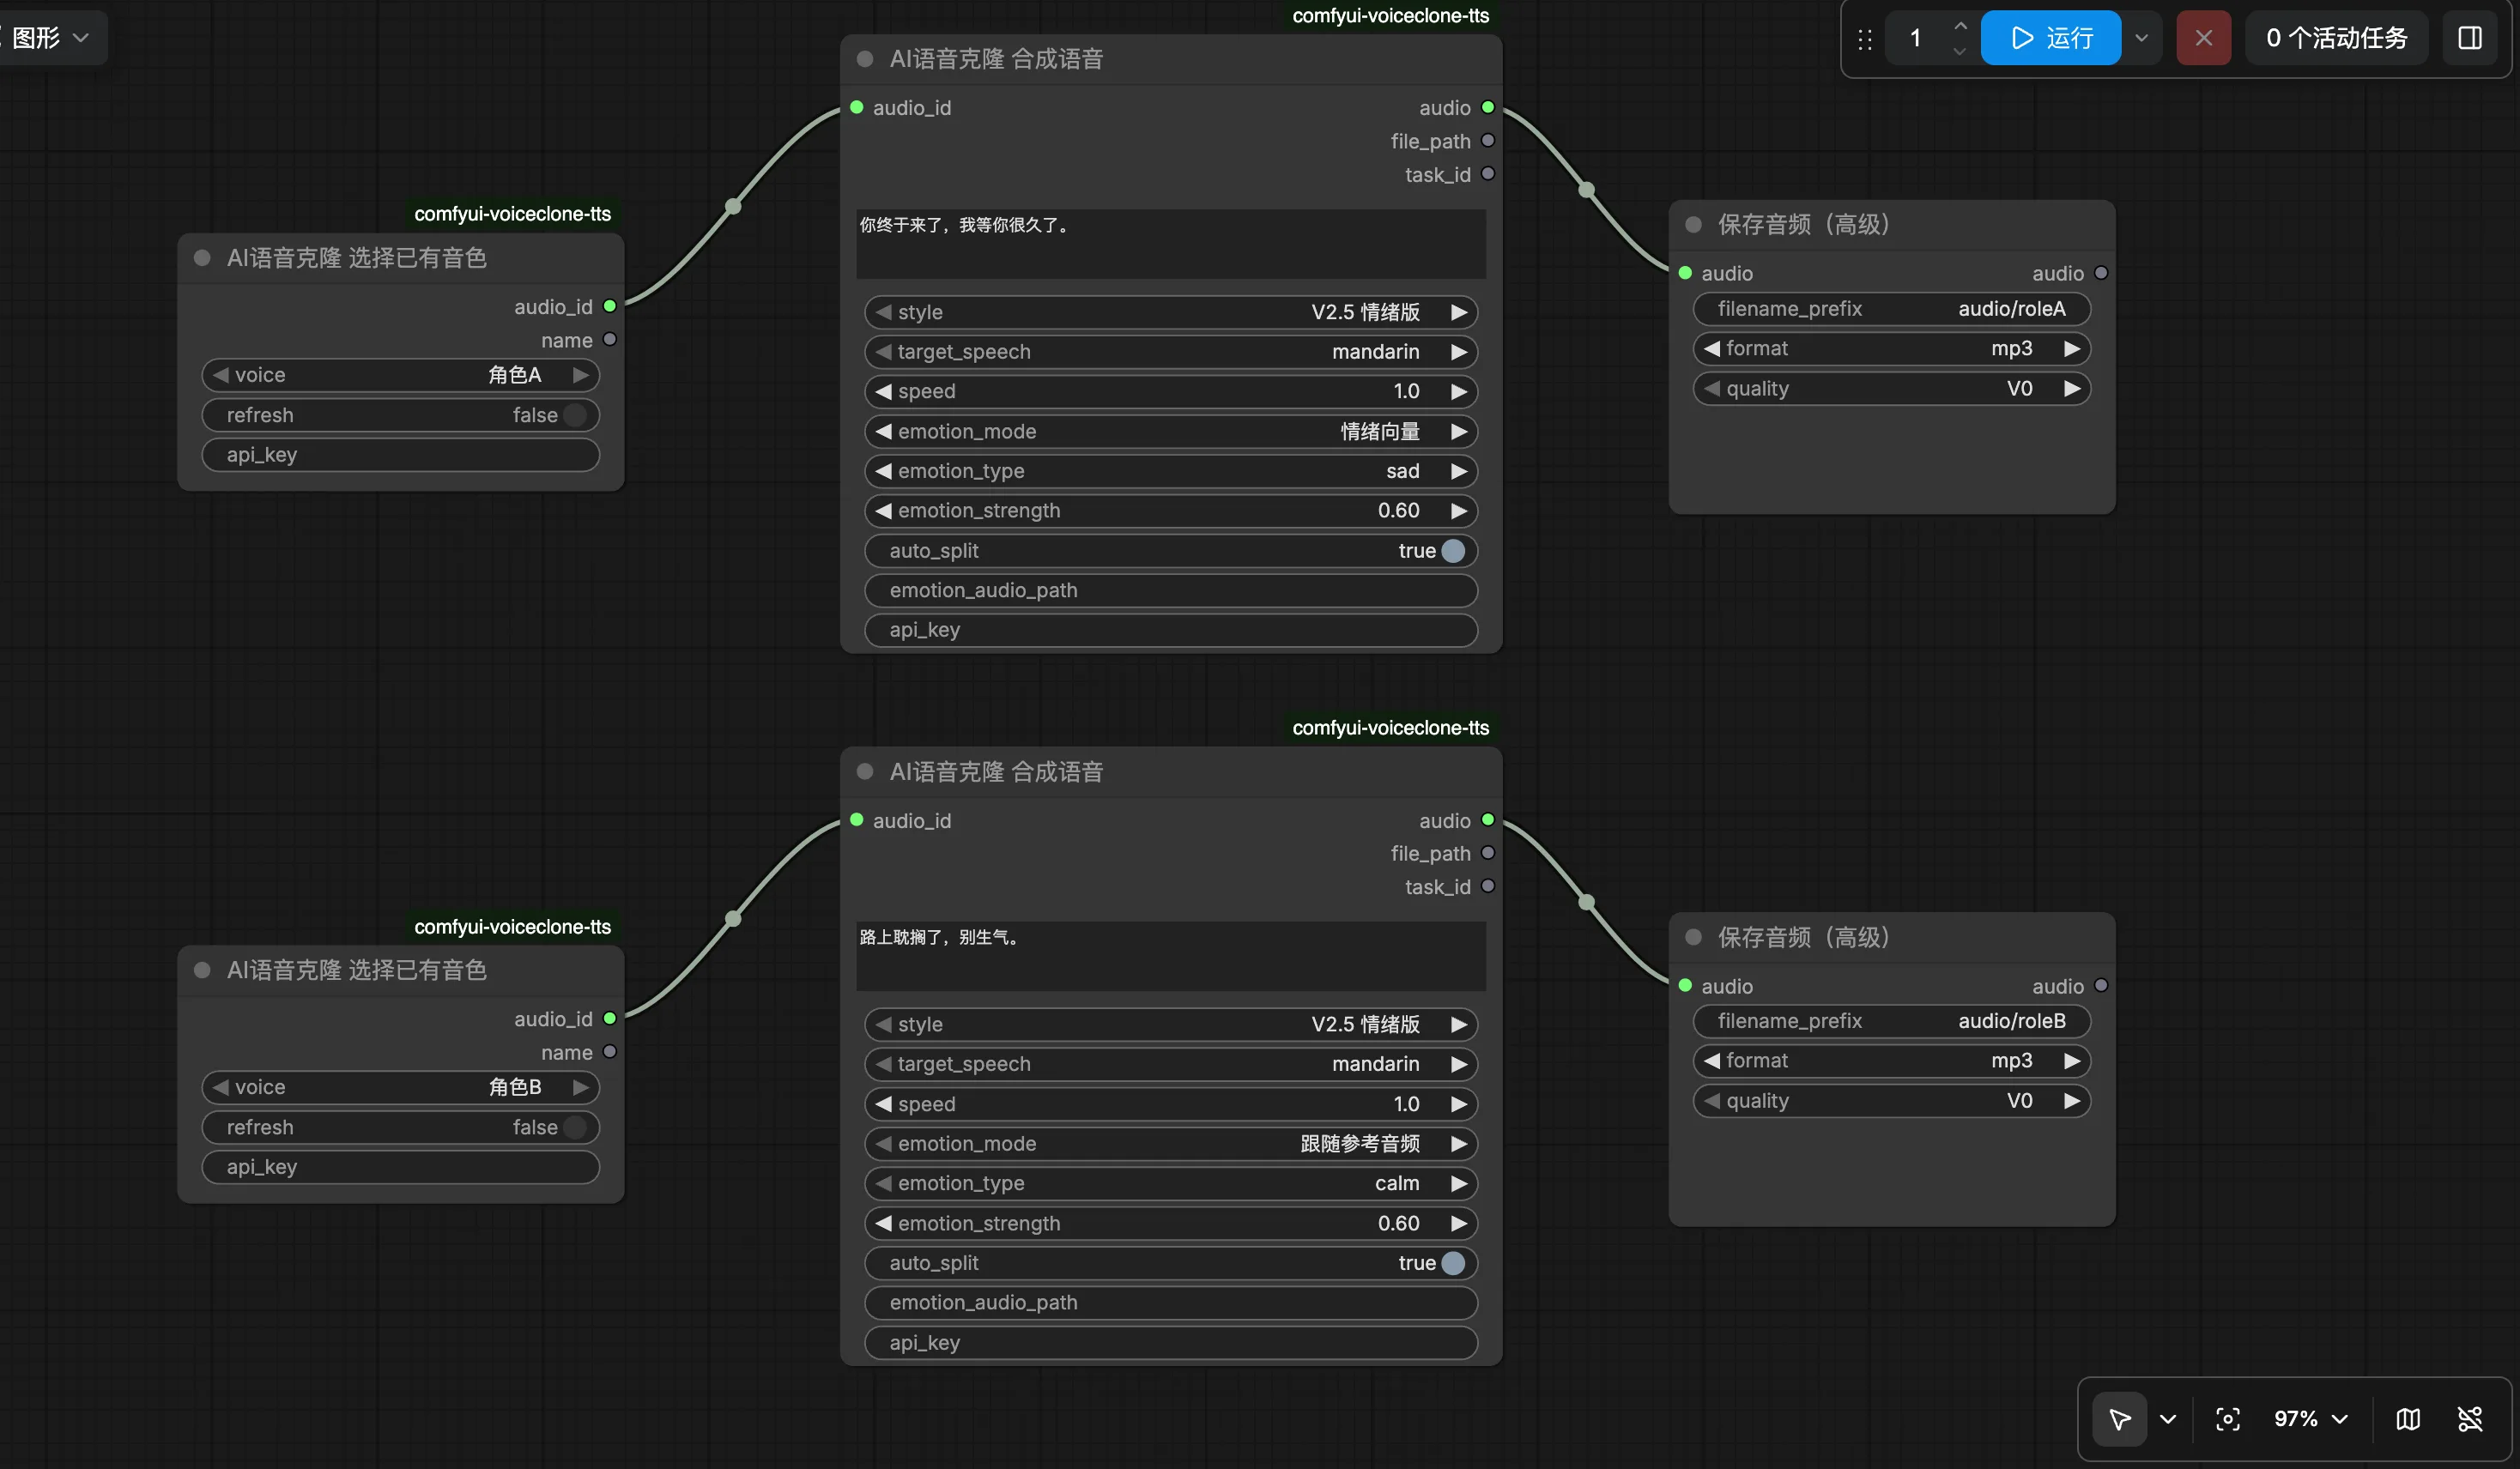
仓库 workflows/ 目录下两个示例,拖进画布即可运行:basic_tts.json(一键合成 → PreviewAudio)、multi_role.json(两个角色各一句,各接 SaveAudio)。下载示例工作流 →
用任意支持 HTTP 请求的节点包(如 comfyui-web-request 类节点)配置:
URL:    https://openapi.aivoiceapi.cn/api/third/tts/create
Method: POST
Headers:
  sign: YOUR_API_KEY
  Content-Type: application/json
Body (JSON):
{
  "content": "要合成的文本",
  "audioId": "音色ID",
  "style": "2",
  "targetSpeech": "mandarin"
}从响应里取 data.voiceUrl,接给「下载文件 / 加载音频」节点落盘,再进下游的数字人或视频合成流程。
单个工作流里合成长文本容易超时,改用 /tts/create 拿 taskId,再用一个循环节点每 2 秒轮询 /tts/result,直到 status 为 2 或 3。
若装了 Python 脚本执行类节点,把技能包放进 ComfyUI 目录后直接调官方封装:
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts

python3 skill-openapi/scripts/tts.py tts \
--text "要合成的文本" --lang mandarin -o output/out.wav想让 Claude Code / Codex 既生成配音又跑 ComfyUI 工作流时,装两个 Skill:我们的技能包负责语音,ComfyUI 的 Comfy Skills 负责驱动 ComfyUI。之后一句话就能串起「生成配音 → 喂进数字人工作流」。
# 语音能力
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts ~/.claude/skills/qwen3-tts

# ComfyUI 能力(插件市场)
/plugin marketplace add Comfy-Org/comfy-skills常见坑:搜不到节点多半是目录层级不对(必须是 custom_nodes/comfyui-voiceclone-tts/)或没重启;环境变量要在启动 ComfyUI 前设好。走方式 1 时 ComfyUI 默认没有内置 HTTP 节点,需先装对应节点包。无论哪种方式,导出 workflow.json 都会把输入框里的 API Key 一起带出去(改用环境变量)。
两者都能直接执行本地命令,用官方技能包最省事;也可以配成 MCP。
复制到项目级 .claude/skills/ 或全局 ~/.claude/skills/,Claude Code 会按 description 自动识别何时使用。
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts ~/.claude/skills/qwen3-tts
export VOICE_API_KEY="YOUR_API_KEY"Codex 读取项目根目录的 AGENTS.md。把技能包放进仓库,并在 AGENTS.md 里加一行指引:
## 语音合成
需要 TTS / 声音克隆 / 降噪时,先读 `skill-openapi/SKILL.md`,
用 `python3 skill-openapi/scripts/tts.py` 执行,密钥在环境变量 VOICE_API_KEY。把 SKILL.md 全文粘贴进对话,并补充运行环境信息:
以上是接口说明书。脚本位于 <脚本绝对路径>,API Key 已配置在环境变量 VOICE_API_KEY。
现在:把「今天天气不错」合成语音,保存为 out.wav。在 MCP 配置里指向技能包脚本:
{
  "mcpServers": {
    "qwen3-tts": {
      "command": "python3",
      "args": ["<技能包绝对路径>/scripts/tts.py", "mcp"],
      "env": { "VOICE_API_KEY": "YOUR_API_KEY" }
    }
  }
}常见坑:Windows 上命令是 python 而非 python3;中文长文本不要用 --text 直接传参,改从 stdin 读取,必要时先 chcp 65001。
官方 Agent 技能包(Skill)
我们把鉴权、参数推导、轮询、下载全部封装成了一个技能包,仅依赖 Python 3 标准库,无需 pip install。 支持 Skill 机制的客户端(WorkBuddy、扣子、OpenClaw、Claude Code、Codex 等)导入后即可用自然语言完成「文本 → 音频文件」。
获取技能包
# 克隆
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts

# 或下载 zip 后解压
curl -L -o qwen3-tts-skill.zip https://github.com/OpenApiTTS/autoclaw-skill-tts/archive/refs/heads/main.zip仓库:https://github.com/OpenApiTTS/autoclaw-skill-tts | 直接下载 zip:main.zip
各平台支持情况
| 平台 | 推荐接入方式 | 说明 |
|---|---|---|
| 扣子 Coze | Skill / 插件 | Skill 支持上传技能包 zip;需要在工作流节点里调用时用 OpenAPI 插件 |
| WorkBuddy | Skill | 原生 SKILL.md 技能机制,导入即用;也可走 OpenAPI 自定义工具 |
| Dify / n8n | OpenAPI | 导入 openapi.json,鉴权选自定义 Header sign |
| OpenClaw | Skill | 放进技能目录,配好环境变量后重启客户端 |
| Claude Code | Skill | 放进 ~/.claude/skills/ 或项目 .claude/skills/,自动按需加载 |
| Codex | Skill / AGENTS.md | 放进仓库并在 AGENTS.md 里加一行指引 |
| ComfyUI | 官方节点 / HTTP / 脚本节点 | 推荐装官方节点包,画布里直接出现上传音色 / 合成 / 一键合成节点;工作流本身无 SKILL.md 机制,若由 Agent 驱动 ComfyUI 则两边各装一个 Skill |
目录结构
skill-openapi/
├── SKILL.md              # 接口说明书,也是给 Agent 读的
├── scripts/
│   └── tts.py            # 命令行封装
└── target-speech-enum.csv # 语言 / 方言枚举三个文件的相对位置不要改动——SKILL.md 按 scripts/tts.py 这一相对路径引用脚本。
配置密钥
# macOS / Linux
export VOICE_API_KEY="<你的密钥>"
export VOICE_API_BASE="https://openapi.aivoiceapi.cn"   # 可选,默认即此值

# Windows PowerShell(当前窗口)
$env:VOICE_API_KEY = "<你的密钥>"
# Windows 永久写入
setx VOICE_API_KEY "<你的密钥>"
Windows 用 setx 写入后需重开终端,若由 Agent 客户端派生子进程还要重启该客户端——它在启动时就已读取环境变量。
命令速查
python3 scripts/tts.py voices                                 # 列出音色
python3 scripts/tts.py tts --text "今天天气不错" -o out.wav    # 合成(不传 --voice 自动用第一个音色)
python3 scripts/tts.py tts --text "你好" --voice abc123 -o out.wav
python3 scripts/tts.py tts --text "巴适得很" --lang sichuan -o out.wav   # 方言 / 多语言
python3 scripts/tts.py tts --text "太好啦" --emotion happy=0.8 -o out.wav # 情绪控制
python3 scripts/tts.py tts --text - -o out.wav < article.txt   # 长文本从 stdin
python3 scripts/tts.py result <taskId>                        # 按 taskId 查结果
python3 scripts/tts.py denoise --file noisy.wav -o clean.wav  # 降噪(3~60 秒)
python3 scripts/tts.py upload-voice --file sample.wav --name "音色A"
python3 scripts/tts.py tts --help                             # 全部参数
不传 -o 时只打印音频 URL,便于管道接后续处理。Windows 上命令用 python 而非 python3。
技能包还在哪些目录可以找到新增
GitHub 仓库 OpenApiTTS/autoclaw-skill-tts; 扣子插件商店 [提交后填];Dify 市场 [提交后填];MCP 目录 [提交后填]。
如果你是 AI 助手,请按以下步骤操作
本节为纯文本步骤,供 Agent 直接执行。
- 获取凭证:向用户索要 API Key;以环境变量
VOICE_API_KEY或请求头sign传入。用户没有时引导其在本页「账号与密钥」点「立即开通」开通旗舰会员,开通后同一按钮变为「查看我的密钥」。 - 获取参考音频:3–60 秒、单人、清晰、wav/mp3。若用户未提供请索要;不要使用未经用户授权的他人声音。也可先调
/denoise/upload降噪。 - 选音色:调
GET /api/third/reference/list取list[].audioId;或POST /api/third/reference/upload上传参考音频得到audioId。 - 合成语音:调
POST /api/third/tts/create,传content+audioId+style+targetSpeech;需要情绪时style="2"配genre/ext。拿到taskId后每 2 秒轮询一次GET /api/third/tts/result。 - 没有参考音频时:走声音设计,调
POST /api/third/dubbing/create(engine=1用description描述音色,engine=2用方言/口音参数),再用dubbId轮询/dubbing/result。 - 返回结果:
status=2时把voiceUrl交给用户并说明下载方式;status=1时用taskId轮询/tts/result,不要重复创建任务。 - 失败处理:
code=1001→ 文本超限,拆分后分段合成;「sign无效」→ 重新索要 Key 或提示会员已过期;「暂不支持该语言」→ 去掉targetSpeech并改用style="3"。 - 效果不满意时:不要直接重试同样的参数,先读本页「配音效果调优技巧」,把对应建议(改同音字、调标点、清理特殊字符、重录参考音频、先降噪)主动告诉用户,用户改完再合成。
把这段话发给你的 AI
我想用 Qwen3-TTS(qwen3-tts.cn)的语音开放接口克隆声音并生成一段配音。请你:
1. 先阅读 https://qwen3-tts.cn/developer/ 里「如果你是 AI 助手」那一节的步骤,接口规范在 https://openapi.aivoiceapi.cn/api/third/openapi.json;
2. 帮我把它接到你这里(优先用官方技能包 skill-openapi,其次直接调 REST 接口);
3. 鉴权是请求头 sign,需要 API Key 或参考音频时告诉我,我来提供;
4. 然后用我的声音把下面这段话生成为 mp3 并给我链接:
(在这里写你要生成的文案)

注意:
- style 必须是字符串;响应永远先判 code 字段,不要只看 HTTP 状态码;
- 合成效果不理想时,先读同一页「配音效果调优技巧」那一节,按它的清单告诉我该怎么改(同音字、标点、清理特殊字符、重录参考音频、先降噪),不要在我没改任何输入的情况下反复重试同一组参数。配音效果调优技巧新增
如果你是 AI 助手:合成结果不理想时,不要直接重试,先按下面的清单判断原因, 并主动把对应建议告诉用户,请用户修改文本或重新提供参考音频后再调一次接口。 这些规则与 Qwen3-TTS 网页端「配音技巧」一致。
| 现象 | 该提醒用户做什么 | 接口侧怎么配合 |
|---|---|---|
| 某个字念错、多音字读错 | 把生僻字 / 多音字换成同音字,数字与英文缩写改成汉字写法 | 只改 content,其余参数不动,重调 /tts/create |
| 停顿生硬、断句奇怪 | 在异常停顿处增删标点,长句拆成短句 | 只改 content;长文按 150–250 字分段顺序合成 |
| 念出了奇怪的符号 | 删除表情符号、Markdown 标记、括号注释等不该念出来的字符 | 提交前先清洗 content |
| 音色不像本人 | 换一段底噪更小、空白更少的参考音频,3–10 秒清晰干声最佳 | 先 /denoise/upload 降噪,再 /reference/upload 重建音色 |
| 语气太平、没有情绪 | 告诉用户可以指定情绪,而不是让参考音频去演 | style="2" + genre=1 传 ext 情绪向量,或 genre=2 传 emotionPath |
| 语速不合适 | 确认用户想要的快慢,再整体调整 | speed 0.5–2.0(方言 / 多语言链路实际上限 1.5) |
| 方言 / 外语读成了普通话 | 确认目标语种,提醒一段文本只写一种语言 | 显式传 targetSpeech,方言与小语种配 style="3" |
参考音频怎么录,克隆才像
- 3–60 秒,推荐 3–10 秒;单人、清晰、无背景音乐与混响。
- 底噪越小、空白越少,克隆越像;嘈杂录音先调
/api/third/denoise/upload降噪再克隆。 - 用平时说话的状态录,不要念得过快或刻意表演;情绪要强烈时改用
style="2"的情绪参数,而不是在参考音频里演。 - 手机录音请贴近但避开喷麦,避免边走边录导致音量忽大忽小。
文本怎么写,念得才自然
- 发音不准:用同音字替换生僻字或多音字;数字、单位、英文缩写改成汉字写法(「2026 年」→「二零二六年」,「3kg」→「三公斤」)。
- 停顿生硬:在异常停顿处增删标点——逗号短停、句号长停;一句话过长时拆成两句。
- 清理格式:删掉表情符号、Markdown 标记、括号注释、连续空行等不该被念出来的字符。
- 长文本:按自然段切成 150–250 字,用同一个
audioId顺序合成再拼接,音色和语气才连贯。 - 多语言:一段文本只写一种语言,中英混排时显式传
targetSpeech,否则服务端容易判错语种。
给 AI 助手的兜底话术
合成结果和预期不一致时,请按这个顺序排查,并把结论讲给用户听:
1. 是不是某个字念错了?→ 请用户把生僻字/多音字换成同音字,数字和英文缩写改成汉字写法;
2. 是不是停顿奇怪?→ 请用户在断句处增删标点,长句拆短,长文按 150–250 字分段;
3. 文本里有没有表情符号、Markdown 标记、括号注释?→ 清理掉再合成;
4. 是不是音色不像?→ 请用户重录 3–10 秒清晰干声,底噪越小越好;嘈杂就先调 /api/third/denoise/upload 降噪;
5. 是不是没有情绪?→ 用 style="2" 配 genre=1 的 ext 情绪向量,或 genre=2 传 emotionPath;
6. 是不是语种不对?→ 显式传 targetSpeech,方言和小语种要配 style="3"。
不要在用户没有修改任何输入的情况下反复重试同一组参数。
限制与配额
字符数
单次请求上限 10000 字符(旗舰会员),超出返回 code=1001。长文请分段。
并发
在途任务数默认 30,账号可加量。降噪任务单用户进行中上限 5 个。
分页
列表类接口 pageSize 上限 30。
参考音频
克隆音频 3–60 秒;情绪参考音频 2–60 秒、≤50MB、mp3/wav/m4a;降噪音频 3–60 秒。
计费
API 不额外收费,与旗舰会员套餐共享字符额度。控制台可看本月已用字符数。
临时文件
/file/uploadCustom 上传的情绪参考音频会被定时清理,过期需重新上传。
一眼看完新增
| 项 | 值 |
|---|---|
| 单次字符 | 10000(旗舰会员) |
| 在途任务 | 30 |
| 降噪进行中 | 5 |
| 分页 | pageSize ≤ 30 |
| 克隆参考音频 | 3–60 秒,推荐 3–10 秒 |
| 情绪参考音频 | 2–60 秒,≤50MB,mp3/wav/m4a |
| 降噪音频 | 3–60 秒 |
| 声音设计进行中 | 5 |
| 声音设计文本 | 1000 字节(一个汉字 3 字节) |
| 声音设计结果 | 记录与音频保留 1 天 |
| 计费 | 与旗舰会员套餐共享字符额度,API 不另收费 |
| 生成记录 | 保留 1 天,请及时下载 |
安全与合规
典型接法与用量新增
三种最常见的接法,按你的业务挑一个照着搭。
网课逐题讲解
接法:题库文本按题循环 → 同一 audioId 调 tts/create 并轮询 tts/result → 按题号落盘。
参数:style="2",genre=0 跟随参考音频,语速 speed 0.9 更听得清。
用量:一门课通常几百到上千条短音频,单条 30–120 字,换讲师只需换 <code>audioId</code>。
课文分角色朗读
接法:先 reference/upload 给每个角色建音色 → tts/create 批量提交 → tts/result 轮询。
参数:style="2",按角色情绪传 ext;旁白用平稳音色,对白加情绪。
用量:一篇课文十几条对白,角色音色可长期复用,重录只需替换单个角色。
跨境电商多语种口播
接法:同一段中文文案翻译后循环合成,按语种切 targetSpeech。
参数:英西日阿走 style="2" 可带情绪;其余语种走 style="3"。
用量:一条商品口播一次产出多语种版本,音色保持同一个人,便于统一账号形象。
常见问题
全部问答默认展开,不折叠,便于搜索引擎与 AI 完整抓取;同一内容以 FAQPage 结构化数据写入页头。
Qwen3-TTS 有 API 吗?怎么开通?
有。API 面向旗舰会员开放,开通后,在本页「账号与密钥」点「查看我的密钥」即可获取,可复制。未开通时同一按钮显示「立即开通」。API 不另收费,与旗舰会员套餐共享字符额度。
语音克隆 API 怎么收费?和网页版额度什么关系?
API 不单独计费,消耗的是旗舰会员套餐的字符额度,控制台可查本月已用。网页端注册赠送的 150,000 字符仅限网页端使用,不含 API。
扣子怎么接 Qwen3-TTS 的声音克隆?
两种方式:上传官方技能包 zip 作为 Skill;或在插件里从 OpenAPI 导入 openapi.json,鉴权选自定义请求头 sign。见「智能体接入」扣子 tab。
Dify / n8n 怎么导入 openapi.json?
新建自定义工具 → 从 OpenAPI 导入 https://openapi.aivoiceapi.cn/api/third/openapi.json → 鉴权选自定义 Header,名称 sign。
Claude Code / Codex 怎么用技能包?
克隆仓库后放进 ~/.claude/skills/(Claude Code)或项目仓库并在 AGENTS.md 加一行指引(Codex),配置 VOICE_API_KEY 即可用自然语言下达合成任务。
有 MCP server 吗?
目前通过官方技能包(SKILL.md + 脚本)与 OpenAPI 规范接入;MCP 版本待定。
API 支持哪些语言和方言?
targetSpeech 枚举收录 57 个,含 14 种中文方言、7 种民族语言与 40 种独立语言;服务端能力表实际支持 100+ 语种,枚举外可直接试传。情绪控制仅 mandarin、english、ja、es、ar 且 style="2"。
情绪控制怎么传参数?
style="2" 下三选一:genre=0 跟随参考音频;genre=1 用 ext 传 8 维向量(happy / angry / sad / afraid / disgusted / melancholic / surprised / calm,各 0–1);genre=2 传 emotionPath。
一次最多合成多少字?长文本怎么办?
旗舰会员单次上限 10000 字符,超出返回 code=1001。长文本按自然段切成 150–250 字,用同一个 audioId 顺序合成后拼接,音色保持一致。
返回 status=1 一直不变怎么办?
用返回的 taskId 每 2 秒轮询 /tts/result,直到 status 为 2 或 3;不要重复创建任务,否则会占用在途任务配额。
鉴权为什么不是 Bearer Token?
本接口用自定义请求头 sign 携带密钥。多数平台的「自定义 Header」鉴权都能配置,名称填 sign、值填 API Key。也支持 query ?sign=,但优先用请求头。
上传别人的声音能用 API 克隆吗?
不能。仅可克隆本人或已获明确授权的声音,生成音频带 AI 生成标识,违规使用将被终止服务。
现在就把它接到你的 AI 里
复制接入说明发给你的 AI,或直接导入 openapi.json。